
AI datacenter nguồn điện đang trở thành điểm nghẽn thực tế khi doanh nghiệp mở rộng cụm GPU cho huấn luyện mô hình, inference thời gian thực và dịch vụ AI nội bộ. Với hạ tầng truyền thống, bài toán thường là đủ rack, đủ băng thông, đủ làm mát. Với AI, câu hỏi đầu tiên phải là: nguồn vào có chịu được tải liên tục, tải đỉnh và tốc độ tăng công suất trong 12–36 tháng tới hay không?
Điểm khác biệt nằm ở mật độ. Một cụm GPU có thể đẩy công suất trên mỗi rack lên rất cao so với rack máy chủ web hoặc database thông thường. Khi nhiều rack AI chạy song song, phần điện không chỉ là UPS và máy phát dự phòng. Bạn phải tính cả trạm biến áp, tủ phân phối, busway hoặc cáp, dự phòng N+1, chất lượng điện, làm mát, PUE, lịch chạy job và khả năng mở rộng theo từng giai đoạn.
Bài viết này rà soát các số liệu đáng chú ý trong năm 2026 từ các nguồn công khai, sau đó chuyển thành các khuyến nghị triển khai: ước tính tải, chọn kiến trúc cấp điện, kiểm soát rủi ro vận hành và những điểm doanh nghiệp tại Việt Nam nên chuẩn bị khi xây AI cluster hoặc thuê colocation cho GPU.
Áp lực nguồn điện từ AI datacenter: Số liệu cập nhật 2026
Theo Epoch AI, tính đến tháng 11/2026, một số AI datacenter được theo dõi công khai đã đạt quy mô công suất IT rất lớn. Ví dụ, cơ sở Anthropic-Amazon New Carlisle được Epoch AI ước tính khoảng 1.037 MW công suất IT hiện tại; Colossus 2 khoảng 946 MW; OpenAI Stargate Abilene khoảng 824 MW. Đây là các ước tính theo cơ sở dữ liệu công khai, không nên dùng như số liệu thiết kế cho một dự án cụ thể, nhưng chúng cho thấy xu hướng rõ: năng lực tính toán AI đang kéo theo nhu cầu điện ở cấp cơ sở hạ tầng, không còn là câu chuyện vài phòng máy riêng lẻ.
Ở cấp độ toàn ngành, nguồn CommandLinux trích dự báo của Gartner rằng các máy chủ tối ưu cho AI có thể tiêu thụ khoảng 175 TWh trong năm 2026, tương đương 31% trong tổng 565 TWh điện dùng cho trung tâm dữ liệu toàn cầu. CTAIO, trong bản cập nhật tháng 4/2026, dẫn ước tính rằng data center đã dùng khoảng 485 TWh điện trong năm 2025, tăng từ khoảng 415 TWh năm 2024, và có thể lên khoảng 950 TWh vào năm 2030. Những con số này khác nhau theo phương pháp thống kê, phạm vi tính và giả định tăng trưởng, nên cách đọc đúng là xem chúng như tín hiệu quy mô, không phải một mức cố định áp cho mọi thị trường.
Với kỹ sư vận hành, vấn đề không chỉ là tổng điện năng theo năm. Datacenter AI khó ở chỗ tải có thể tăng rất nhanh khi bạn bổ sung GPU, chuyển từ thử nghiệm sang production hoặc chạy nhiều batch training cùng lúc. Một cụm nhỏ ban đầu có thể chạy ổn trên phương án điện hiện có. Nhưng khi mở rộng lên nhiều rack GPU, điểm nghẽn thường xuất hiện ở nơi ít được chú ý: tủ phân phối còn dư bao nhiêu nhánh, đường cáp có đủ tiết diện không, UPS còn headroom không, máy phát dự phòng có chịu được bước tải lớn không, và hệ thống làm mát có kéo theo phụ tải phụ trợ vượt thiết kế không.
AI workload cũng khác workload doanh nghiệp thông thường. Web, API hoặc database có dao động theo giờ truy cập. Training mô hình lớn có thể chạy nhiều giờ hoặc nhiều ngày ở mức tải cao, làm cho đường cong tiêu thụ điện phẳng hơn và khó “né” bằng các thủ thuật cân bằng tải đơn giản. Inference thì ngược lại: nếu phục vụ người dùng cuối, tải có thể bật lên nhanh theo chiến dịch, sự kiện hoặc tích hợp sản phẩm mới. Vì vậy, khi nói về AI datacenter nguồn điện, bạn nên tách ba lớp: công suất IT của thiết bị tính toán, phụ tải hạ tầng như cooling/UPS/PDU, và năng lực nguồn cấp từ bên ngoài.
Các nguồn tin tổng hợp như The Verge cũng ghi nhận nhiều dự án AI datacenter trên thế giới gặp sức ép từ khả năng cấp điện, thời gian xây dựng lưới, yêu cầu làm mát và phản hồi của địa phương. Với bài toán kỹ thuật, thông điệp cần rút ra là: thời gian đặt GPU có thể tính bằng tháng, nhưng thời gian chuẩn bị nguồn điện, phòng máy, trạm biến áp và phương án dự phòng thường dài hơn. Nếu doanh nghiệp chỉ nhìn vào cấu hình máy chủ, dự án rất dễ kẹt ở bước nghiệm thu hạ tầng.
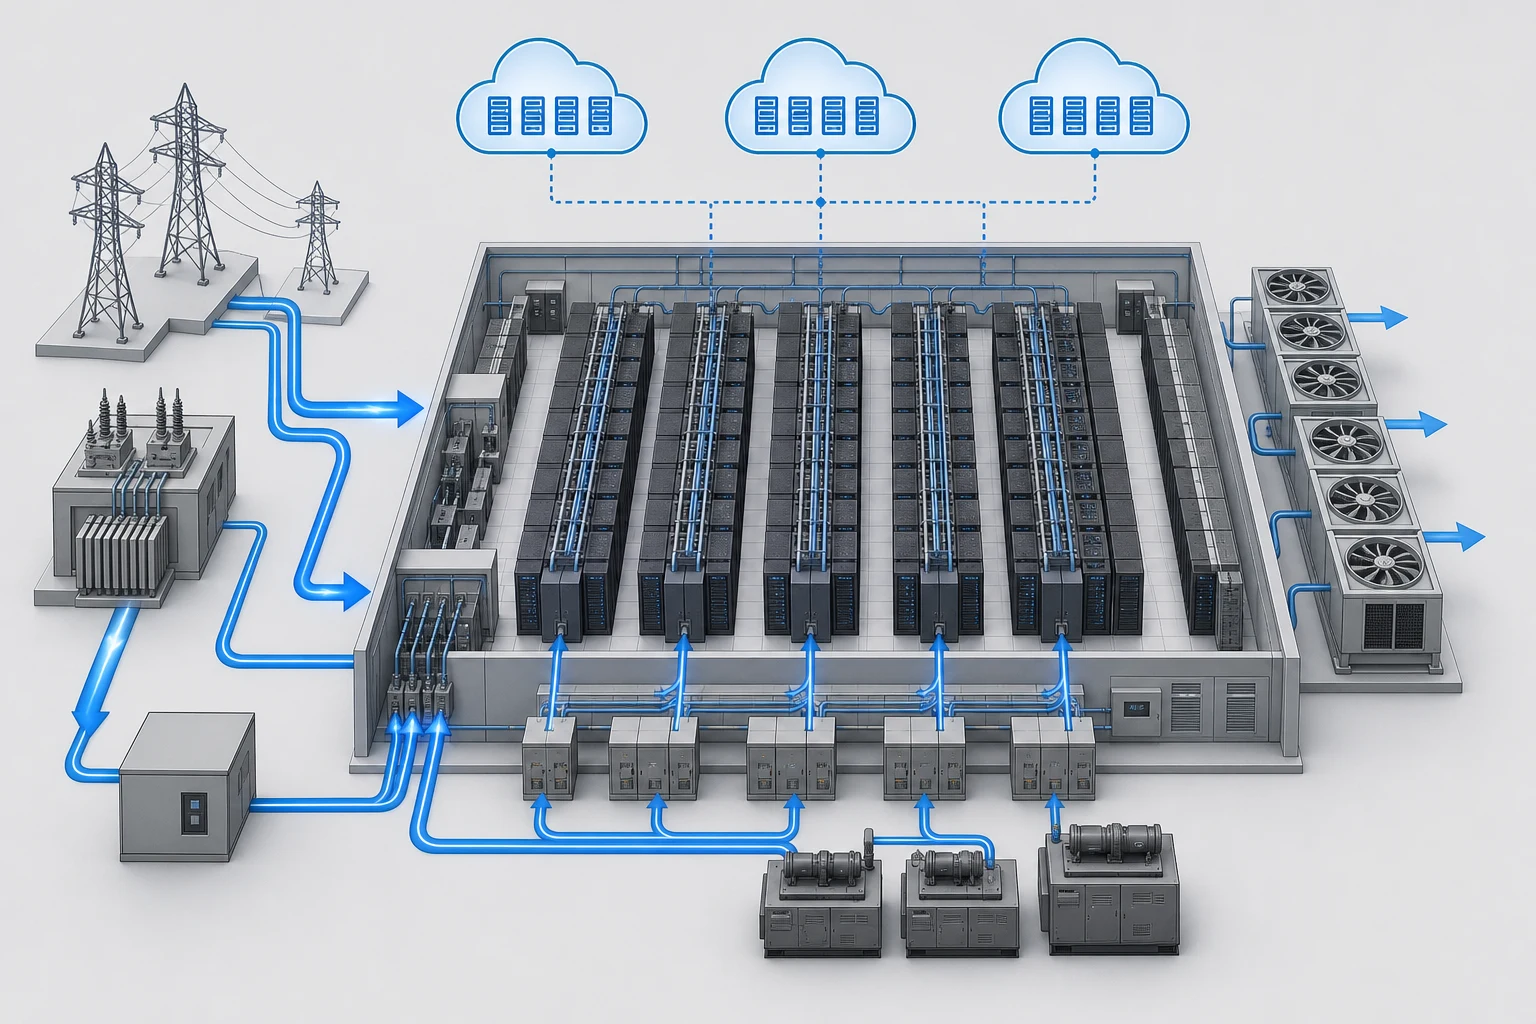
Giải pháp mới cho nguồn điện AI datacenter: Đổi mới kỹ thuật và chiến lược đầu tư
Không có một cách xử lý duy nhất cho bài toán nguồn điện AI. Cách làm an toàn hơn là giảm tải ở nhiều lớp: chọn phần cứng hiệu quả hơn, thiết kế phân phối điện đúng ngay từ đầu, tối ưu lịch chạy job, giám sát chất lượng điện và lập kế hoạch mở rộng theo block. Nếu chỉ mua thêm UPS hoặc tăng máy phát dự phòng, bạn có thể giải quyết được một đoạn, nhưng vẫn còn rủi ro quá tải ở tủ điện, cáp, cooling hoặc nguồn cấp đầu vào.
Ở lớp phần cứng, hiệu suất năng lượng của GPU là biến số đáng chú ý. Theo Spheron, trong ước tính cho năm 2026, H200 đạt khoảng 4,14 tokens/watt với mô hình 70B FP8, so với khoảng 2,86 tokens/watt của H100 và khoảng 5,0 tokens/watt của B200. Số đo tokens/watt phụ thuộc workload, batch size, độ chính xác số học, phần mềm và cách benchmark, nên không nên hiểu là một giá trị tuyệt đối. Tuy vậy, nó cho thấy cùng một mục tiêu xử lý AI, lựa chọn chip và cấu hình phần mềm có thể ảnh hưởng trực tiếp đến công suất tiêu thụ, nhiệt thải và chi phí vận hành.
Ở lớp phân phối điện, AI datacenter nguồn điện thường cần thiết kế theo mật độ rack cao hơn. Điều này kéo theo yêu cầu về busway hoặc PDU phù hợp, đo điện theo từng nhánh, cân bằng pha, bảo vệ quá dòng, kiểm soát nhiệt tại điểm đấu nối và đủ không gian cho mở rộng. Với rack GPU, bạn không nên chỉ kiểm tra tổng kW của phòng. Cần kiểm tra từng đoạn: nguồn A/B, PDU trong rack, ổ cắm hoặc whip, breaker, cáp, tuyến máng, tủ phân phối, UPS, biến áp và nguồn cấp chính. Một mắt xích nhỏ không đạt cũng có thể giới hạn cả cụm.
UPS là phần nhiều đội triển khai đánh giá thiếu. Với hệ thống AI, UPS không chỉ cần đủ kVA/kW trên giấy. Bạn cần xem hệ số công suất, khả năng chịu bước tải, thời gian lưu điện thực tế ở tải dự kiến, chế độ bảo trì bypass, khả năng mở rộng module và cảnh báo pin. Nếu workload có nhiều pha bật/tắt GPU, dòng biến thiên có thể làm lộ điểm yếu ở cấu hình ngưỡng cảnh báo. Một khuyến nghị thực tế là chạy thử tải theo kịch bản xấu: bật đồng thời nhiều node, đưa GPU lên mức tải cao, mô phỏng mất nguồn lưới, kiểm tra chuyển mạch và log lại điện áp, tần số, nhiệt độ, trạng thái UPS.
Ở lớp vận hành, job scheduling giúp giảm đỉnh tải nếu bạn kiểm soát được hàng đợi huấn luyện. Ví dụ, các job training lớn có thể được xếp lịch theo khung giờ nguồn và cooling ổn định hơn; job inference quan trọng được ưu tiên tài nguyên; job thử nghiệm có thể bị giới hạn công suất hoặc chạy trên cụm riêng. Một số nền tảng cluster cho phép đặt giới hạn power cap cho GPU. Cách này có thể làm giảm hiệu năng tức thời, nhưng trong nhiều trường hợp lại tăng độ ổn định tổng thể, nhất là khi nguồn vào hoặc cooling chưa được nâng cấp kịp.
Với dự án mới, bạn nên chia giai đoạn đầu tư theo block công suất thay vì dồn toàn bộ ngay từ đầu. Mỗi block cần có hồ sơ rõ: bao nhiêu rack, bao nhiêu kW/rack, PUE mục tiêu, phương án làm mát, cấp dự phòng, đường đi cáp, vị trí tủ điện, không gian bảo trì và mốc nâng cấp tiếp theo. Cách chia này giúp đội kỹ thuật, tài chính và nhà cung cấp hạ tầng cùng nói trên một bộ số liệu. Khi làm việc với đơn vị điện lực, tư vấn thiết kế và các bên thẩm định liên quan, doanh nghiệp cũng có cơ sở rõ hơn về nhu cầu công suất, tiến độ đóng điện và phương án vận hành an toàn.
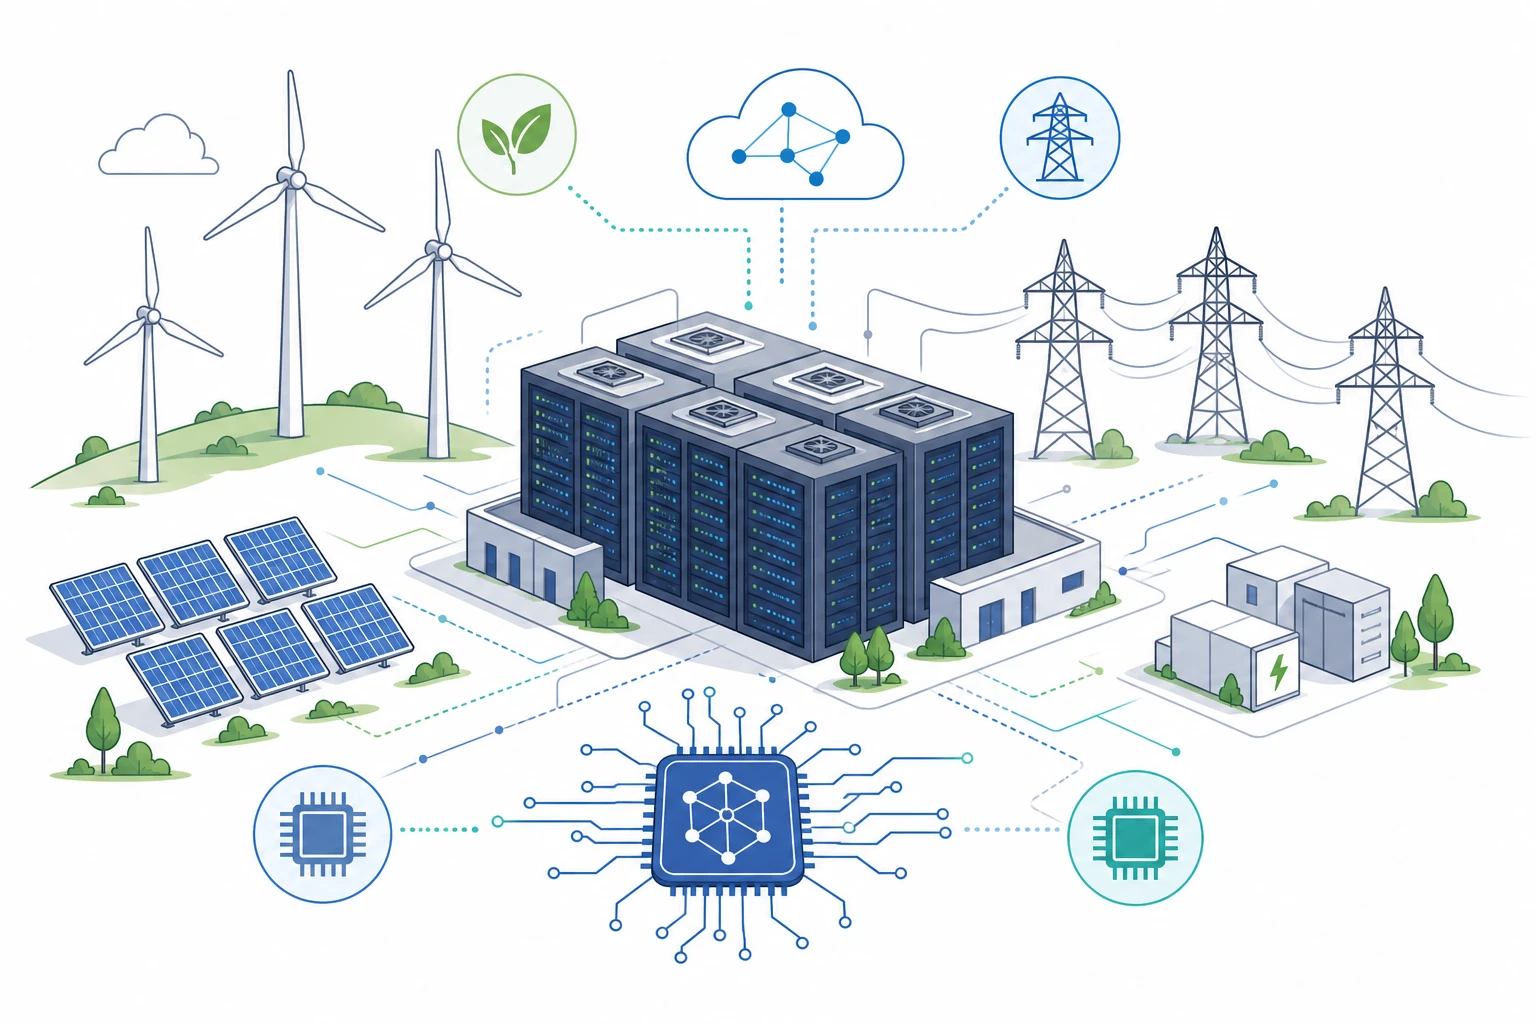
AI datacenter nguồn điện: thiết kế để vận hành bền vững
Vận hành bền vững ở đây không phải khẩu hiệu. Với cụm AI, nếu điện và làm mát không được thiết kế đồng bộ, hệ thống có thể phải chạy dưới công suất, liên tục cảnh báo hoặc bị giới hạn mở rộng. CTAIO trong bản cập nhật tháng 4/2026 dẫn dự báo mức điện dùng cho data center có thể tăng đáng kể tới năm 2030; nguồn tham khảo thêm có thể xem tại IEA. Khi đọc các dự báo này, doanh nghiệp nên chuyển chúng thành câu hỏi thiết kế cụ thể: tải IT tối đa là bao nhiêu, PUE mục tiêu là bao nhiêu, nguồn dự phòng cấp mấy, và hệ thống có chịu được mở rộng sau 18 tháng không.
Cách ước tính cơ bản nên bắt đầu từ công suất IT. Bạn liệt kê số server GPU, switch, storage, server quản trị và thiết bị phụ trợ trong rack. Với mỗi loại, lấy công suất danh định và công suất vận hành dự kiến. Sau đó cộng lại để có công suất IT tối đa. Điện tổng cho cơ sở thường được ước tính gần đúng bằng công suất IT nhân với PUE. Ví dụ, nếu cụm IT dự kiến 500 kW và PUE mục tiêu 1,4, điện tổng cần chuẩn bị cho hạ tầng có thể xấp xỉ 700 kW, chưa tính phần dự phòng theo cấp thiết kế. Đây chỉ là cách tính sơ bộ; khi triển khai thật, cần kỹ sư điện và MEP tính chi tiết theo tiêu chuẩn thiết kế, điều kiện mặt bằng và yêu cầu uptime.
Một lỗi hay gặp là lấy công suất trung bình của server để đặt hạ tầng. Với AI, bạn nên thiết kế theo kịch bản tải cao có kiểm soát, vì training hoặc inference batch lớn có thể kéo GPU lên mức tiêu thụ gần đỉnh trong thời gian dài. Nếu chỉ tính theo tải trung bình, hệ thống có thể chạy được lúc nghiệm thu nhẹ nhưng gặp lỗi khi đưa workload thật vào. Dấu hiệu thường thấy là breaker nhảy khi bật đồng loạt node, PDU cảnh báo quá tải theo nhánh, UPS giảm thời gian lưu điện quá nhanh, hoặc nhiệt độ đầu vào rack tăng dù CRAC/CRAH vẫn báo đang chạy.
Chất lượng điện cũng cần được đo liên tục. Không chỉ đo kWh. Bạn nên theo dõi điện áp, tần số, dòng theo pha, hệ số công suất, độ lệch pha, sự kiện sụt áp, tăng áp, harmonic và trạng thái chuyển nguồn. Các cảm biến này nên tích hợp vào DCIM hoặc hệ thống giám sát hiện có để đội vận hành nhìn được theo rack, theo tủ và theo phòng. Khi có bất thường, log phải đủ chi tiết để truy ngược: sự cố xảy ra ở nguồn ngoài, UPS, tủ phân phối, PDU hay thiết bị IT.
Làm mát là phần gắn chặt với nguồn điện. GPU tiêu thụ nhiều điện thì nhiệt thải cũng tăng tương ứng. Nếu dùng air cooling, bạn cần kiểm tra airflow, blanking panel, containment nóng/lạnh, áp suất sàn nâng nếu có, nhiệt độ đầu vào rack và khoảng trống phía sau rack. Nếu dùng liquid cooling, bài toán chuyển sang vòng nước, CDU, rò rỉ, chất lượng nước, cảm biến, bảo trì và phương án xử lý khi một nhánh làm mát gặp lỗi. Dù dùng phương án nào, phụ tải cooling phải được đưa vào bài toán AI datacenter nguồn điện ngay từ đầu, không để tới sau khi chọn xong server mới tính.
Ở Việt Nam, doanh nghiệp triển khai AI cluster thường có ba lựa chọn: đặt trong phòng máy tự vận hành, thuê colocation có sẵn tiêu chuẩn hạ tầng, hoặc dùng cloud/GPU cloud. Nếu tự vận hành, bạn kiểm soát được thiết bị nhưng phải chịu toàn bộ phần điện, cooling, phòng cháy chữa cháy, giám sát và nhân sự trực. Nếu thuê colocation, cần hỏi rõ công suất khả dụng theo rack, loại nguồn A/B, giới hạn kW/rack, khả năng hỗ trợ rack GPU, phương án làm mát, quy trình nâng cấp và thời gian cấp thêm điện. Nếu dùng cloud, bạn giảm gánh nặng hạ tầng vật lý nhưng vẫn cần quản trị quota GPU, lịch chạy job, chi phí vận hành và dữ liệu.
Với AI datacenter nguồn điện, checklist tối thiểu trước khi ký mua thiết bị gồm: công suất IT từng giai đoạn; mật độ rack dự kiến; PUE mục tiêu; sơ đồ một sợi; cấp dự phòng; dung lượng UPS và máy phát; thời gian lưu điện; phương án bảo trì không gián đoạn; tải cooling; vị trí đặt rack nặng; tuyến cáp nguồn và mạng; cảnh báo giám sát; quy trình phản ứng sự cố. Nếu thiếu một trong các mục này, bạn vẫn có thể mua GPU, nhưng khả năng đưa vào khai thác ổn định sẽ thấp hơn.
Một điểm thực tế khác là firmware, driver và workload cũng ảnh hưởng tới điện. Cùng một GPU, cấu hình power limit, driver, runtime, batch size, precision và cách phân bổ job có thể tạo ra mức tiêu thụ khác nhau. Đội AI và đội hạ tầng nên thống nhất một bộ benchmark nội bộ: chạy training mẫu, inference mẫu, đo điện tại PDU, ghi nhiệt độ, đo throughput và tính hiệu quả theo workload của chính doanh nghiệp. Không nên chỉ dựa vào thông số marketing hoặc benchmark công khai, vì workload sản xuất thường khác điều kiện thử nghiệm.
Khi hệ thống đi vào vận hành, cần đặt ngưỡng cảnh báo theo cấp. Cảnh báo mức 1 có thể là rack vượt 70–80% công suất khuyến nghị trong thời gian dài. Mức 2 là một nhánh PDU lệch tải hoặc nhiệt độ đầu vào rack tăng bất thường. Mức 3 là UPS, breaker, nguồn A/B hoặc cooling có sự kiện nghiêm trọng. Mỗi mức nên có runbook: ai nhận cảnh báo, kiểm tra màn hình nào, giảm tải cụm nào, tạm dừng job nào, liên hệ bên nào, và ghi nhận sự cố ra sao. Runbook càng rõ, thời gian xử lý càng ngắn.
Nguồn năng lượng tái tạo và hệ lưu trữ có thể là một phần của chiến lược dài hạn, nhưng cần nhìn thực tế. Điện mặt trời hoặc nguồn tái tạo có tính biến thiên theo thời tiết và thời điểm. Hệ pin lưu trữ giúp làm phẳng một phần tải hoặc hỗ trợ trong tình huống nhất định, nhưng phải được thiết kế bởi đơn vị chuyên môn và tích hợp an toàn với hệ thống điện hiện hữu. Với datacenter, ưu tiên đầu tiên vẫn là nguồn ổn định, chuyển mạch đúng, bảo vệ đầy đủ và khả năng bảo trì có kế hoạch.
Để theo dõi thêm xu hướng nguồn điện cho AI datacenter trên thế giới, bạn có thể tham khảo phân tích của Reuters. Khi áp dụng vào dự án tại Việt Nam, hãy dùng các bài phân tích này như dữ liệu tham khảo, sau đó kiểm chứng lại bằng khảo sát mặt bằng, hồ sơ điện, yêu cầu workload và năng lực vận hành của đội kỹ thuật.
Lỗi thường gặp khi triển khai nguồn điện cho cụm AI
- Chỉ tính công suất server, quên phụ tải hạ tầng.
GPU node là phần dễ nhìn thấy nhất, nhưng cooling, UPS loss, PDU, switch, storage và hệ thống giám sát cũng dùng điện. Nếu bỏ qua PUE, dự toán sẽ thiếu. - Đặt rack GPU vào khu vực chỉ phù hợp rack mật độ thấp.
Rack có thể vừa về diện tích nhưng không đủ điện hoặc airflow. Trước khi lắp, cần kiểm tra giới hạn kW/rack, tải sàn, đường cáp và hướng gió. - Không thử kịch bản bật tải đồng thời.
Nhiều hệ thống chạy ổn khi bật từng node, nhưng gặp lỗi khi orchestration đưa nhiều GPU lên tải cao cùng lúc. Nên kiểm tra bằng workload mô phỏng trước khi production. - Thiếu đo điện theo nhánh.
Nếu chỉ có đồng hồ tổng, đội vận hành khó biết rack nào gây đỉnh tải, pha nào lệch, hay PDU nào gần quá tải. Đo theo nhánh giúp xử lý nhanh hơn. - Không có kế hoạch mở rộng.
AI thường bắt đầu bằng thử nghiệm nhỏ rồi tăng nhanh. Nếu thiết kế ban đầu không chừa không gian điện và làm mát, lần mở rộng sau sẽ tốn thời gian hơn.
Một số câu hỏi thường gặp khi xây dựng AI datacenter nguồn điện
- Làm sao ước tính tải điện trung bình của datacenter AI?
Bạn cần xác định số lượng GPU node, công suất từng node, switch, storage, server quản trị và phụ tải hạ tầng. Công thức sơ bộ: Điện tổng cơ sở ≈ Công suất IT x PUE. Sau đó cộng phần dự phòng theo thiết kế và kiểm tra từng nhánh phân phối điện. - Datacenter AI có cần hệ nguồn điện dự phòng riêng?
Thông thường là có, nhất là với workload sản xuất. Tối thiểu cần UPS, phương án chuyển nguồn, máy phát hoặc nguồn dự phòng phù hợp với yêu cầu uptime. Mức dự phòng cụ thể phụ thuộc SLA, ngân sách, mặt bằng và rủi ro chấp nhận được. - Ứng dụng AI nào tiêu thụ điện nhiều nhất trong datacenter?
Huấn luyện mô hình lớn thường tiêu thụ nhiều điện do GPU chạy tải cao trong thời gian dài. Inference cũng có thể tạo tải lớn nếu phục vụ lưu lượng cao hoặc yêu cầu độ trễ thấp. Cách chắc chắn nhất là đo trên workload thật của bạn. - Khó khăn gì thường gặp khi phối hợp năng lượng tái tạo cho AI datacenter nguồn điện?
Vấn đề chính là độ ổn định theo giờ/mùa, năng lực lưu trữ, phương án hòa lưới hoặc cấp riêng, bảo vệ điện và vận hành khi nguồn biến thiên. Với datacenter, mọi nguồn bổ sung cần được tích hợp theo thiết kế an toàn. - Có nên giới hạn công suất GPU để giảm áp lực điện không?
Có thể cân nhắc. Power cap giúp giảm đỉnh tải và nhiệt, đôi khi đổi lại hiệu năng thấp hơn. Bạn nên benchmark theo workload thật để tìm điểm cân bằng giữa throughput, độ ổn định và điện năng. - Khi thuê colocation cho GPU, nên hỏi nhà cung cấp điều gì?
Hãy hỏi giới hạn kW/rack, nguồn A/B, loại PDU, khả năng hỗ trợ liquid cooling nếu cần, PUE tham khảo, quy trình cấp thêm điện, giám sát theo nhánh, thời gian phản ứng sự cố và điều kiện lắp rack nặng.
Nếu bạn đang lên kế hoạch triển khai cụm GPU, colocation hoặc hạ tầng AI, hãy bắt đầu bằng bản tính tải điện và kịch bản mở rộng. DCT có thể hỗ trợ bạn rà soát yêu cầu hạ tầng, kết nối phần cứng, cloud, VPS/GPU và phương án vận hành phù hợp. Liên hệ dct.vn | 0913320866 | [email protected].
